
Les IA de recherche ont un défaut connu : elles livrent souvent des résultats répétitifs. Pour une requête large comme « matériel de camping », on reçoit dix tentes, pas un kit complet. Google propose une stratégie innovante pour briser ce cercle. Son approche, pensée pour un moteur de recherche en production, apprend hors ligne ce que doit être un bon éventail de réponses, puis l’exécute en temps réel, sans latence inutile. À la clé : une vraie diversité des réponses, une meilleure optimisation des résultats et une vitesse qui tient la charge.
Le cœur du problème se résume en deux points. D’un côté, les modèles classiques se contentent de reformuler une idée en boucle. De l’autre, leur génération pas à pas allonge les temps de réponse. En 2026, alors que la recherche se joue à la milliseconde, cette lenteur plombe l’expérience. Ici, Google sépare l’apprentissage automatique de l’exécution. Il entraîne une fois un plan d’attaque grâce à un système de récompense précis, puis le distille dans un petit modèle qui répond instantanément. Résultat : un algorithme de recherche qui pense comme un expert, agit vite, et couvre le sujet sans tourner en rond.
En bref
- Problème : paraphrases en chaîne et lenteur des modèles autorégressifs qui créent des résultats répétitifs.
- Réponse de Google : un fan-out entraîné une fois hors ligne, puis distillé dans un modèle compact exécuté en un passage.
- Chiffres : 53,9 millions de paramètres, génération simultanée, 12 à 20 fois plus rapide que les approches séquentielles.
- Qualité : récompense à 3 critères — ancrage, diversité (Vendi Score), alignement — pour éviter les doublons et les dérives.
- Impact : meilleure diversité des réponses, panier moyen renforcé, expérience de recherche claire.
Pourquoi les IA de recherche produisent des résultats répétitifs
Les systèmes de fan-out décomposent une requête large en sous-requêtes. Sans réglage fin, l’intelligence artificielle reformule la même idée. « Style festival bohème » devient « mode festival bohème », puis « vêtements festival bohème ». Trois fois la même piste. L’utilisateur, lui, attend « veste à franges », « robe en crochet », « bottes en daim ».
Deux causes dominent. D’abord le « collapse paraphrastique » : le modèle maximise une similarité de sens trop stricte. Ensuite la latence : un modèle autorégressif génère des centaines de jetons intermédiaires pour planifier ses requêtes. Idéal pour une conversation, pas pour un moteur de recherche qui doit couvrir dix angles d’un coup.
Le piège de la reformulation et la latence autorégressive
Confier la décomposition à un LLM standard revient à demander « plus du même ». Le système privilégie des variantes proches, car c’est la solution la plus sûre mathématiquement. Résultat : une page qui tourne en rond.
Côté vitesse, la génération token par token crée un plancher de latence. À grande échelle, les temps grimpent jusqu’à des dizaines de secondes quand le contexte explose. Pour une requête commerce en pic de trafic, c’est trop tard. L’essentiel : viser des angles distincts, sans faire payer l’utilisateur en secondes perdues.
La stratégie innovante de Google pour casser la monotonie
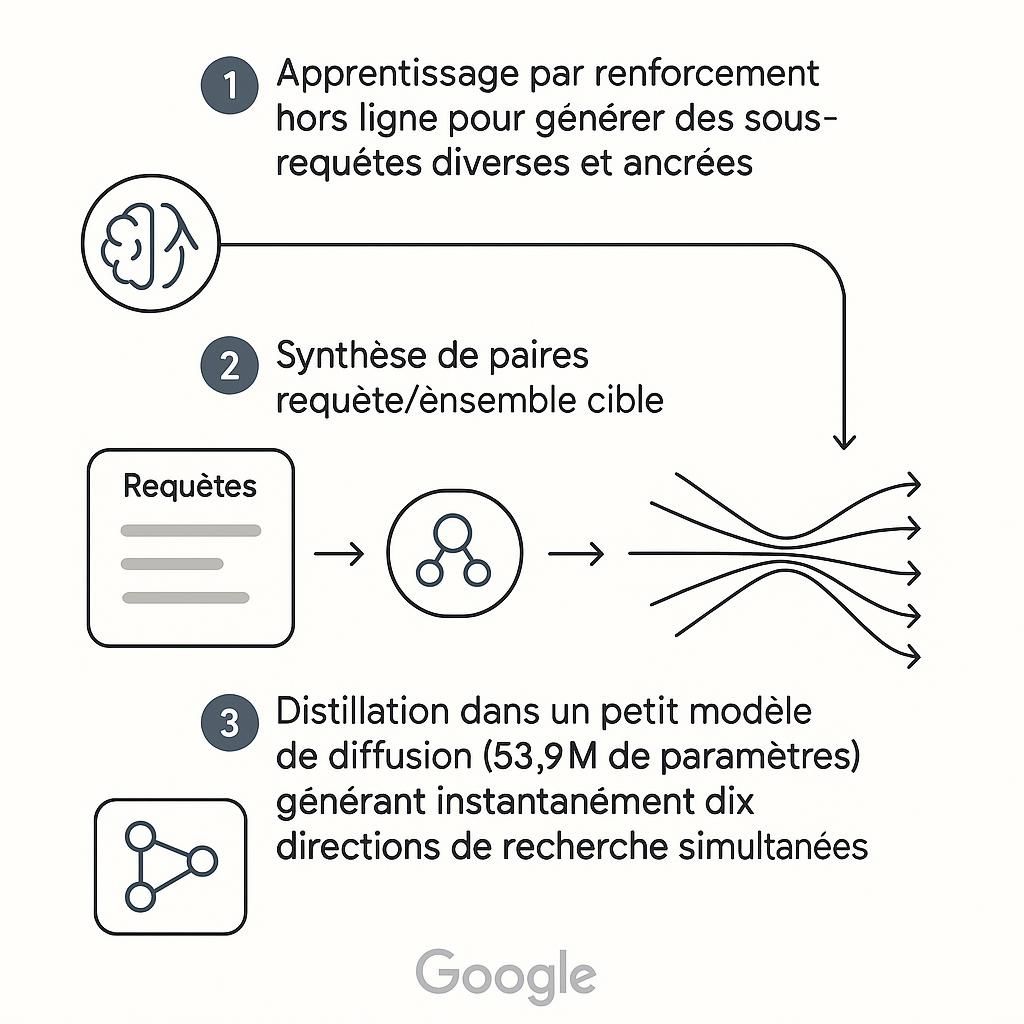
Google propose « Retrieve‑for‑Train » : on entraîne une fois, on exécute instantanément. Le raisonnement se fait hors ligne via apprentissage automatique. En ligne, un modèle léger applique le plan, sans texte intermédiaire.
Trois étapes structurent le pipeline. 1) Un modèle de fan-out est optimisé par renforcement pour produire des sous-requêtes utiles en groupe. 2) Ce modèle génère, hors ligne, des paires requête / ensemble cible sans intervention humaine. 3) Un modèle de diffusion compact (53,9 millions de paramètres) apprend à projeter directement une requête vers un ensemble d’embeddings cibles, en un seul passage, non séquentiel.
Concrètement, on remplace un long raisonnement texte par une prédiction géométrique dans l’espace vectoriel. Le modèle sort d’un coup dix directions pertinentes, prêtes à lancer la récupération d’items. Le gain est double : plus de variété, moins d’attente.
Un système de récompense en trois piliers
La qualité repose sur une récompense qui juge l’ensemble des résultats. Trois forces tirent dans le bon sens. L’ancrage pénalise toute sous-requête éloignée de la base réelle. La diversité, mesurée par un Vendi Score, écarte les doublons et pousse à explorer plusieurs zones sémantiques. L’alignement rattache chaque piste à l’intention d’origine.
Isoler un seul pilier crée des effets pervers. Optimiser l’ancrage seul mène à des requêtes absurdes mais « valides » côté base. Ajouter seulement l’alignement favorise la paraphrase. La diversité agit comme contrepoids : pour marquer, le modèle doit être précis, fidèle… et différent. L’équilibre, pas le hasard, produit la diversité des réponses.
Des chiffres qui changent la donne
Déployer directement le modèle entraîné par renforcement offre une belle qualité, mais garde la lenteur autorégressive. Distiller ce savoir dans un modèle de diffusion supprime ce goulot. Les tests montrent un gain de 12 à 20 fois sur la vitesse, avec une latence qui reste de la fraction de seconde à quelques secondes, même avec de gros lots.
Sur des corpus mode (texte-image) et musique (texte-audio), cette approche dépasse le zéro-shot et les stratégies Best‑of‑N. Là où les baselines produisent des paraphrases, Retrieve‑for‑Train ajoute « bottes » ou « dentelle » quand le thème est « bohème ». Le signal fort : la diversité utile bat la variété cosmétique.
Pour un décideur, ces écarts se traduisent en clics mieux répartis, en paniers plus complets, et en pages qui couvrent un sujet sans tunnels redondants. La performance se voit au premier scroll.
Ce que ça change pour les marques, les éditeurs et le SEO
Imaginez Luna, responsable e‑commerce d’une marque outdoor. Sa recherche interne renvoyait autrefois dix tentes. Avec ce fan-out de nouvelle génération, la page propose tente, duvet, réchaud, frontale, filtres à eau. Le panier se construit visuellement. L’optimisation des résultats ne consiste plus à pousser un produit, mais à composer un ensemble.
Côté SEO, un algorithme de recherche qui comprend les ensembles revalorise les pages thématiques riches et complémentaires. La requête « camping minimaliste » gagne si elle couvre les angles essentiels, pas si elle répète trois fois le même équipement. Besoin d’un cadre pratique ? Consultez cette analyse complète pour relier production éditoriale et signaux d’intention multi‑produits.
- Structurez vos données : catégories nettes, attributs normalisés, variantes distinctes. L’IA de recherche ne peut diversifier que ce qu’elle perçoit.
- Pensez en kits : créez des pages et des blocs qui regroupent des items complémentaires. Le moteur apprend plus vite ce qu’est une « bonne couverture ».
- Mesurez la diversité : suivez la répartition des clics et la redondance des résultats. Un pic de paraphrases signale un appauvrissement.
- Testez l’alignement : confrontez vos ensembles à des requêtes réelles. L’intention reste le nord de la boussole.
- Accélérez la récupération : investissez dans des index d’embeddings adaptés à la génération simultanée.
Pour aller plus loin côté stratégie éditoriale et produit, explorez le dossier spécial d’août 2026 qui synthétise les impacts concrets sur les roadmaps de contenu et d’UX. L’axe à retenir : penser « ensemble pertinent » plutôt que « résultat isolé ».
